

● L’IA peut challenger nos certitudes en cherchant contradictions et sources complémentaires, mais ses analyses dépendent fortement de la façon dont nous formulons nos hypothèses.
● Plus la gestion de la connaissance est automatisée, plus la curation humaine devient essentielle : ce qui entre dans le système conditionne ce qu’il restitue, et la confiance qu’on peut lui accorder.
La veille est au cœur de mon métier : elle me permet de détecter les signaux faibles et de comprendre les mouvements de fond de l’écosystème technologique. Cependant, j’avais atteint une limite : plus de deux heures par jour à lire, analyser, recouper et organiser l’information. Une question persistait : comment maintenir une connaissance cohérente dans le temps, alors que les informations s’accumulent et que certaines deviennent obsolètes ?
Un wiki personnel associé à un LLM
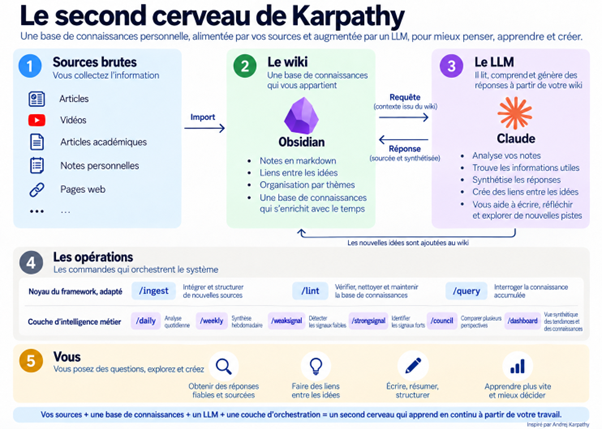
Je me suis appuyé sur le pattern « LLM Wiki » proposé par Andrej Karpathy, cofondateur d’OpenAI et ancien directeur de l’IA de Tesla. L’idée : plutôt que d’obliger un LLM à redécouvrir sa documentation à chaque requête, lui confier l’entretien d’un wiki personnel qui s’enrichit à chaque nouvelle source ajoutée.
Concrètement, j’utilise Obsidian comme interface, Git pour conserver l’historique et Claude Code pour réaliser l’analyse et la production. Tout reste en local, en Markdown. Quand j’ajoute une source capturée depuis mon navigateur, le système en extrait concepts et entités, les relie aux connaissances existantes, puis vérifie la cohérence de l’ensemble.
Une demi-journée de mise en place a suffi, puis un processus itératif pour affiner et développer les opérations de mon second cerveau, et ma veille quotidienne est passée de deux heures à trente minutes. La clé : formaliser d’abord ma propre façon de travailler, en tant qu’humain, puis laisser Claude Code en dériver les détails et implémenter les opérations qui m’accompagnent dans ma veille quotidienne.
Reste une question ouverte : la tenue dans le temps. L’ingestion de mes sources quotidiennes, qui prenait une minute au début, en demande aujourd’hui une dizaine.
Une IA qui challenge ce que je crois savoir
Cette vérification régulière est la fonctionnalité qui m’apporte le plus. Une opération de contrôle, le « lint », passe régulièrement le wiki en revue : contradictions, affirmations devenues obsolètes, idées importantes reposant sur une seule source… Le système me propose alors de les confronter à d’autres. L’IA devient un sparring partner qui m’oblige à questionner la solidité de ce que je crois savoir.
J’ai progressivement ajouté des synthèses quotidiennes et hebdomadaires, la détection de signaux faibles et forts, et même un « conseil » : un panel de personas qui examinent une même question sous différents angles. J’avais d’abord imaginé des personas de grands patrons de la tech, avant d’y renoncer : trop de caricature, trop de pensée unique. Autre leçon, inattendue : selon la façon dont je formule une thèse ou une antithèse, j’oriente fortement ce que le système trouve. Une IA peut challenger mon raisonnement, mais elle hérite aussi facilement de mes biais.
Ce que je ne veux pas déléguer à la machine
Plus je délègue à l’IA la gestion de ma connaissance, plus je mesure l’importance de ce que je garde : le choix de mes sources et mon jugement.
C’est moi qui décide qu’un article, une étude ou une analyse mérite d’entrer dans mon second cerveau. J’aurais pu automatiser cette collecte, mais j’ai besoin de savoir sur quoi repose ce que le système me restitue. Je laisse à la machine la mémoire, les rapprochements et une bonne partie de la maintenance. Je reste celui qui choisit ce qui mérite d’être regardé, et qui décide, au final, quoi en penser.