

Gérer les biais, seule solution pour plus d’équité.
Sur le plan de l’équité, on parle de biais dans l’IA lorsque les systèmes perpétuent, voire renforcent des préjugés et inégalités existants entre des individus ou entre groupes, qu’ils soient privilégiés ou non. Si ces biais ne sont pas contrôlés, ils peuvent entraîner des discriminations, interdites par la loi, et nuire à la confiance du public envers la société qui délivre le service. Face à l’intégration croissante de l’IA dans des domaines critiques comme l’emploi, la santé, la justice ou le crédit, il devient particulièrement urgent de lutter contre ces biais. L’Union européenne a mis en place l’AI Act, un cadre réglementaire pionnier qui impose aux entreprises d’identifier, de réduire et de gérer les biais tout au long du cycle de vie de l’IA. Cela inclut la sélection de données représentatives, la conception de modèles capables de détecter et atténuer les biais, ainsi que le suivi continu des systèmes.
Une gestion efficace des biais favorise l’équité et la performance et permet la transparence et la confiance, tout en améliorant la justesse des décisions. Elle participe au renforcement de la réputation des organisations, contribue à assurer leur conformité réglementaire et à attirer des employés et des clients soucieux d’éthique.
L’intersectionnalité révèle la complexité des discriminations en IA. Des outils innovants sont nécessaires pour mesurer et atténuer ces biais multidimensionnels.
La définition de l’équité est éminemment contextuelle
L’équité est un sujet éthique et donc subjectif par essence. Sa définition est éminemment contextuelle. Pour mesurer les biais contenus dans un modèle d’IA puis potentiellement les atténuer, il est nécessaire de passer par de multiples étapes, qui chacune viennent interroger le contexte culturel et opérationnel dans lequel l’utilisation du modèle s’inscrit.
Il faut d’abord s’intéresser aux jeux de données servant à entrainer le modèle et à ses différentes variables. Elles renferment les informations sur lesquelles le modèle construira ses prédictions. Parmi celles-ci, certaines (ex. le genre, l’âge, l’origine) peuvent s’avérer discriminantes dans le contexte envisagé. Il convient d’identifier ces attributs dits sensibles. Ils seront alors traités différemment : ils permettent de définir les groupes (ou sous-groupes dans le cas de l’intersectionnalité) dits démographiques, au regard desquels on cherchera à maintenir une équité.
Il convient ensuite de définir ce que serait un traitement du modèle préjudiciable au regard d’un individu ou d’un groupe et, par contraste, ce qu’est une situation acceptable – à défaut d’avoir une situation idéale d’équité.
Une fois ces définitions actées, on peut procéder à la quantification des biais et à la mesure de l’équité du modèle final en utilisant des métriques d’équité. En cas de biais, des actions d’atténuation devront être menées en utilisant divers outils existants.
Les métriques existantes ne permettent pas de gérer l’intersectionnalité
Les métriques d’équité existantes sont assez limitées. En effet, la plupart ne permettent de comparer les individus ou les groupes que dans un cadre binaire, c’est-à-dire en ne considérant qu’un unique attribut sensible (ex. genre OU âge OU origine, etc.) qui ne peut prendre que deux valeurs (ex homme/femme, junior/senior, urbain/rural, bac+5/pas bac+5, etc.).
La réalité des discriminations est cependant souvent plus complexe et demande une approche dite « intersectionnelle ». Elle consiste à étudier comment certains sous-groupes, définis par la combinaison de plusieurs caractéristiques sensibles (par exemple un groupe des jeunes femmes domiciliées en zones rurales), peuvent subir des discriminations renforcées. En effet, ces situations combinées peuvent entraîner des formes de discrimination plus graves que la simple addition des discriminations liées à chaque critère pris séparément.
Prenons l’exemple d’un modèle de tri de CV. Les métriques classiques permettent de vérifier qu’il est aussi performant pour les hommes que pour les femmes. Elles permettent aussi de vérifier qu’il l’est autant pour les personnes ayant un Bac+5 que pour celles qui n’en ont pas. Mais elles ne permettent pas de garantir simultanément l’équité pour les quatre sous-groupes issus de la combinaison de ces deux critères : hommes Bac+5, femmes Bac+5, hommes sans Bac+5, et femmes sans Bac+5.
Une obligation légale
Le règlement européen sur l’IA (AI Act) ainsi que diverses législations obligent les organisations à s’assurer de l’absence de biais discriminatoires. Le droit européen compte quatorze critères de discrimination. Le droit français ajoute neuf autres critères dont les mœurs, l’apparence physique, la qualité de lanceur d’alerte, la vulnérabilité résultant de la situation économique, etc. En ajoutant la problématique intersectionnelle à cette liste de critères, on doit potentiellement considérer toutes les sous-catégories issues des combinaisons de ces différents critères, démultipliant le nombre de groupes de population à considérer. Les critères de discrimination à prendre en compte et le découpage de la population en groupes démographiques dépendent du contexte. Par exemple, le sexe biologique d’un individu est un critère de discrimination connu cependant, dans le cas d’un modèle de santé, il est probable qu’il soit pertinent qu’il génère une différence de traitement de la part du modèle car les corps masculins et féminins ne doivent pas toujours recevoir les mêmes traitements.
« Il s’agit alors de lutter contre la discrimination multiple, voire possiblement de mesurer les conséquences intersectionnelles des biais algorithmiques. Avec cette approche multidimensionnelle (ou intersectionnelle), il apparait clairement que la recherche d’un équilibre parfait entre autant de seuils statistiques, même pour une seule exigence, s’avère être une tâche complexe, mais indispensable. » (source)
Multiples groupes, multiples disparités : quels choix techniques pour mesurer ces écarts de traitement ?
Gérer l’équité en intersectionnalité revient à s’assurer qu’un modèle est aussi performant pour chacun des sous-groupes, selon un critère bien choisi au regard de la définition d’équité envisagée. Cela nécessite de choisir la façon dont on va comparer la performance du modèle entre les différents sous-groupes. En effet, si comparer la performance d’un modèle entre deux groupes est simple (on peut calculer la différence ou le ratio), il n’en va pas de même pour plus de deux groupes.
Par exemple, pour vérifier qu’un système de recommandation est aussi pertinent pour les hommes que pour les femmes, il suffit de comparer les performances du modèle entre ces deux groupes, par différence ou par ratio. En revanche, si nous souhaitons évaluer la pertinence des recommandations pour quatre sous-groupes intersectionnels (femmes jeunes, femmes âgées, hommes jeunes, hommes âgés), nous devons alors comparer simultanément quatre valeurs de performance.
Comment allons-nous comparer les sous-groupes ? Allons-nous comparer chaque paire de sous-groupes deux à deux, ou chaque sous-groupe à la moyenne ? Ou bien, au lieu de comparer sous-groupes par sous-groupes, allons-nous mesurer directement la relation entre la sortie du modèle et les attributs sensibles (sexe, âge, etc.) ? Toutes ces méthodes existent et ne mettent pas nécessairement en avant les mêmes répartitions d’avantages/inconvénients entre sous-groupes. Chacune présente donc ses avantages et ses inconvénients. Il faut choisir celle qui correspond le mieux à ce que l’on considère comme équitable et acceptable.
Certains travaux de recherches ont proposé des métriques d’équité adaptées à l’intersectionnalité mais sans toujours expliquer clairement les raisons du choix d’une méthode de comparaison plutôt qu’une autre. Cette absence de justification crée a minima un manque de transparence rendant la problématique invisible. L’absence de justification pourrait également témoigner d’une absence de réflexion approfondie sur ce point. Or il est important d’être transparent et de comprendre les implications des choix techniques, afin de s’assurer que ces implications sont normativement alignées avec les objectifs envisagés et que le modèle d’IA pourra être considéré comme responsable au regard des résultats qu’il fournit.
Le besoin d’une méta-métrique d’équité s’impose pour réduire la complexité
Que ce soit pour élaborer des normes d’évaluation, comparer plusieurs modèles afin de choisir le plus équitable, ou gérer les biais lors de l’entraînement d’un modèle, il est utile d’avoir un score synthétique. Or, dans le cas de l’intersectionnalité, la multiplication des sous-groupes crée de nombreux indicateurs. Ces derniers peuvent se révéler difficiles à appréhender pour l’esprit humain. Il est donc nécessaire de réduire cette complexité en permettant la comparaison des modèles sur la base d’un score unique. Celui-ci, appelé « méta-métrique », est alors appliqué aux résultats de chaque sous-groupe. Cela permet de simplifier la comparaison et d’évaluer l’équité d’un modèle dans son ensemble.
Le choix de la méta-métrique influe sur le classement des modèles selon le critère d’équité, et potentiellement sur le choix du modèle retenu in fine.
La méta-métrique qui vise à rassembler tous les résultats obtenus pour chaque sous-groupe en un seul score global peut en effet être calculée de différentes manières. Elle peut par exemple prendre la forme d’une norme qui compte l’occurrence de dépassement d’un seuil donné pour les écarts entre sous-groupes. Un autre type de méta-métrique peut choisir de mesurer l’information partagée entre les attributs sensibles et la métrique d’équité. Ces multiples possibilités peuvent encore être augmentées de variantes, notamment via la pondération. On peut donner plus ou moins de poids à un groupe ou un écart selon : la taille des groupes, leur identité, la discrimination subie… In fine, plusieurs types de méta-métriques sont possibles, chacune donnant une interprétation différente des résultats.
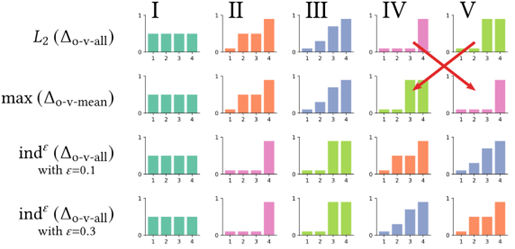
Comme le montre l’image ci-dessous, ces différentes options ne mènent pas à des évaluations équivalentes. Selon la méthode retenue, le modèle considéré le plus équitable peut ne pas être le même, ou du moins, les classements relatifs de l’équité de ces modèles peuvent varier. Même si toutes les méthodes s’accordent sur le cas trivial d’équité parfaite (cas I dans l’exemple ci-dessous), elles peuvent donner des résultats différents dans des situations plus réalistes où des écarts existent. La Figure 1 illustre concrètement que le choix de la méthode influence la conclusion : il encode une position normative et peut renverser le classement des modèles.
Relier le choix technique aux implications concrètes
Pour choisir entre les différentes méthodes d’agrégation, il faut comprendre comment elles prennent en compte la répartition des inégalités entre sous-groupes. L’idéal d’équité absolue correspond à une situation où aucune disparité n’est observée dans les mesures d’équité pour chaque sous-groupe (voir distribution I dans la figure 1). Cette situation est cependant rare et reste plus un objectif qu’une réalité atteignable. En pratique, des écarts d’inégalités existeront toujours.
Les vraies questions sont : comment souhaite-t-on répartir ces disparités ? Si elles persistent : veut-on protéger le sous-groupe le plus défavorisé en limitant l’écart maximal ? Cherche-t-on à réduire les biais systémiques en limitant la fréquence des disparités ? Accepte-t-on des écarts importants entre sous-groupes, à condition qu’ils soient rares ? Ou veut-on s’assurer que le modèle ne se base pas sur les attributs sensibles pour faire ses prédictions ?
Selon des objectifs priorisés, il faut choisir une méthode d’agrégation qui reflète ces priorités. Cela permet d’obtenir une mesure des biais intersectionnels qui est cohérente / « alignée » avec la conception et les valeurs que l’on souhaite privilégier.
Perspectives
L’intersectionnalité révèle la complexité des discriminations en IA. Des outils innovants sont nécessaires pour mesurer et atténuer ces biais multidimensionnels. L’important est de dépasser les limites des outils actuels, trop restreints par rapport au champ des possibles et manquant d’éclairage sur leurs implications normatives et les justifications des choix techniques ayant mené à ces implications.
La spécificité de l’évaluation des biais dans le cadre intersectionnel mise en lumière dans cet article est une première pierre à l’édifice.
Il s’agira ensuite de fournir les différents outils correspondant aux multiples possibilités présentées, toutes nécessaires pour garantir une gestion des biais tenant compte des complexités du monde et fiable.
Orange Research, au travers de travaux de thèse, œuvre à cet objectif et les dernières avancées de nos recherches sur le sujet ont été présentées à la conférence FAccT 2026. N’hésitez pas à lire l’article pour en savoir plus.
Qu’est-ce que l’intersectionnalité en IA ?
L’intersectionnalité est un concept théorique développé par Kimberlé Crenshaw qui examine comment différentes formes de discrimination se croisent et interagissent. En IA, cela signifie qu’un modèle peut être équitable lorsqu’on examine séparément le genre ou l’âge, mais discriminatoire lorsqu’on considère simultanément ces deux critères. Par exemple, un système de recommandation peut bien fonctionner pour les hommes et pour les femmes pris séparément, mais défavoriser spécifiquement les jeunes femmes ou les hommes seniors. Cette approche multidimensionnelle est essentielle pour garantir une véritable équité dans les systèmes d’IA.
Glossaire
Intersectionnalité
Approche qui analyse comment plusieurs formes de discrimination (genre, âge, origine, etc.) se combinent et s’amplifient mutuellement, créant des situations de désavantage spécifiques.
Attributs sensibles
Variables dans un jeu de données qui peuvent être discriminantes dans un contexte donné (ex. genre, âge, origine ethnique, niveau d’études).
Biais algorithmiques
Distorsions dans les résultats produits par des algorithmes, souvent dues à des données biaisées ou à des modèles mal conçus.
Groupes démographiques
Sous-ensembles de population définis par un ou plusieurs attributs sensibles.
Métriques d’équité
Outils mathématiques permettant de quantifier les biais et de mesurer le degré d’équité d’un modèle d’IA.
Méta-métrique
Méthode qui agrège les résultats de plusieurs métriques d’équité en un score unique, permettant une évaluation globale.
Mitigation (atténuation)
Ensemble d’actions visant à réduire les biais identifiés dans un modèle d’IA.
AI Act
Règlement européen sur l’intelligence artificielle, visant à encadrer son développement et son utilisation pour garantir la sécurité et les droits fondamentaux.
Sources :
[1] Beyond Base Metric : Critical and Overlooked Role of Meta-Metrics in Intersectional Fairness (p. 7143). https://doi.org/10.48550/arXiv.2604.28030
[2] Monnier, J., George, T., Guyard, F., Tarnec, C., & Kountouris, M. (2026). MIFair : A Mutual-Information Framework for Intersectionality and Multiclass Fairness (arXiv:2604.28030). arXiv. https://doi.org/10.48550/arXiv.2604.28030
[3] White Paper “Bias in AI: what regulation requires and how entreprises can put it in action” https://mailchi.mp/impact-ai/ai-bias
[4] IA non biaisée : Les entreprises sont-elles prêtes ? (2021, octobre 11). Hello Future. https://hellofuture.orange.com/fr/ia-non-biaisee-les-entreprises-sont-elles-pretes/
[5] Plaidoyer pour une IA éthique et responsable dès la conception. (2021, mai 7). Hello Future. https://hellofuture.orange.com/fr/plaidoyer-pour-une-ia-ethique-et-responsable-des-la-conception/
[6] Makhlouf, K., Zhioua, S., & Palamidessi, C. (2021). Machine learning fairness notions: Bridging the gap with real-world applications. Information Processing & Management, 58(5), 102642. https://www.sciencedirect.com/science/article/abs/pii/S0306457321001321
En savoir plus :
Pour approfondir le sujet de l’intersectionnalité dans l’IA, vous pouvez consulter les ressources suivantes :
- [1] Buolamwini, J., & Gebru, T. (2018, January). Gender shades: Intersectional accuracy disparities in commercial gender classification. In Conference on fairness, accountability and transparency (pp. 77-91).
- [3] Foulds, J. R., Islam, R., Keya, K. N., & Pan, S. (2020, April). An intersectional definition of fairness. In 2020 IEEE 36th international conference on data engineering (ICDE) (pp. 1918-1921). IEEE.
- [4] Molina, M., & Loiseau, P. (2022). Bounding and approximating intersectional fairness through marginal fairness. Advances in Neural Information Processing Systems, 35, 16796-16807.
- [5] Kang, J., Xie, T., Wu, X., Maciejewski, R., & Tong, H. (2022, December). Infofair: Information-theoretic intersectional fairness. In 2022 IEEE international conference on big data (big data) (pp. 1455-1464). IEEE.
- [6] Monnier J, George T, Guyard F, Tarnec C, Kountouris M. “Beyond Base Metric: The Critical and Overlooked Role of Meta-Metrics in Intersectional Fairness” (FAccT 2026)
 Christèle Tarnec
 Jeanne Monnier